
两条轨道与一个误区
2024年,政府工作报告部署“人工智能+”行动,教育部随后启动人工智能赋能教育行动试点。当前,高等教育的AI化已然从可选项变为必答题。
但“必答”不意味着“同答”。清华、浙大、上交大等高校的信息化部门拥有大规模GPU算力集群和专职AI团队,可以自研基础模型。而省属高校的网络信息中心,十来个人同时管网络、管系统、管安全、管数据——真正能投入AI方向的,通常就一两个人。年度信息化经费只有几百万,留给AI的不到一百万。“双一流”高校已开展系统性、全链条的智能化改革布局,许多地方高校的AI应用却仍停留在单一功能模块层面。有研究对147所“双一流”高校的统计显示,已有125所完成DeepSeek本地化部署,而省属高校甚至未被纳入统计样本。
面对悬殊的差距,一种常见的反应是观望。“资金少、人手缺,根本跟不上部属高校的节奏。”但这一判断忽略了一个关键事实:通用大模型比拼的是算力与综合研发实力,而垂直领域大模型比拼的是行业场景、专属数据和业务理解深度——这恰恰是省属高校可以建立的护城河。部属高校学科门类广、体量大,AI建设必须兼顾全校,很难在单一领域深耕;省属高校办学定位清晰、特色学科突出,手握独家教学、科研和行政管理数据,无需在通用模型赛道上硬拼。资源有限不是停滞的借口,而是倒逼省属高校放弃同质化跟风、走专精路线的推力。
“做加法”为什么会输
面对AI建设的新基建竞争,本能反应是做加法。别人建了算力集群,我们也买服务器;其他高校上线了智能问答、学情分析、AI中台,我们也立项。任务清单越拉越长,每个方向都沾一点,但每个都差口气。这不是建设,只是在用堆项目掩盖焦虑,并可能在后续付出代价。
代价一是资源空转。一笔AI投入动辄数十上百万,可能占全年信息化经费的三分之一。系统上线三个月后却无人问津,这已经是部分学校的现实。和成熟的商业应用相比,当前高校AI应用整体仍处于“局部探索、浅层应用”阶段。浅层就意味着,投入与产出的回报率远未到达拐点。
代价二是能力稀释。“学完即淘汰”是省属高校技术人员的真实困境。如果只有一两人负责AI方向,却同时铺开七八个项目,结果必然是每个项目都浮在表面。“师资队伍素养不足”是高校AI应用的关键瓶颈之一。何雅妍等对53个典型案例的分析发现,技术自主性缺失与领导推动力缺失是导致低融合度的两个重要原因[1]——这正是省属高校的典型处境。
代价三是信任透支。师生对校内AI平台的耐心是有限的。第一个系统不好用,忍了;第二个还不好用,回去用DeepSeek和豆包;到第三个,连打开都不会了。一旦“学校的AI就是不好用”的标签贴上,后续功能再强也难以挽回。姜思羽等对世界前百高校GenAI使用指南的研究表明,即使一流高校也会选择“审慎开放、主动治理”的AI应用路线[2],而非粗放式全面铺开。
代价四是数据“裸奔”。新发布的《教育数据分类分级指南》明确要求学校开展数据分类分级工作。省属高校若在数据治理尚未到位的情况下匆忙将敏感数据接入大模型,无异于在安全底线上走钢丝。
如何做减法
做减法不是不建,是把有限的力量集中到最有价值的靶点上。
一是场景上做减法。一所省属高校同时推进的AI项目,不应超过三个。要避免“为了技术而技术”的盲目跟风,在资源有限情境下,聚焦关键场景,是通往深度应用的有效路径。什么样的场景最值得优先投入?三个条件:使用频率高、规则明确、痛点突出。可以选专业咨询、选课咨询、论文格式审查、评审材料辅助撰写、PPT格式调整等。这些“低垂果实”的共同优势在于,不需要最前沿的算法就能产生立竿见影的效果。
二是技术上做减法。省属高校不需要满血版部署AI模型,不需要自研基座模型,不需要独立建设算力集群。“云端API+本地轻量化模型”的混合策略,足以覆盖绝大多数使用场景。要量力而行、需求牵引、集约建设,这不是退而求其次,而是清醒的务实主义。
三是组织上做减法。省属高校没有条件组建大型AI团队,但也不该把AI建设变成信息化部门的独角戏。正确的做法是“打破部门墙”:本科生院、研究生院和科发院提需求,信息中心做技术落地,学工处推使用,人事处给激励。可构建“师生+各部门+AI”深度融合的协同模式,AI是“处理海量数据、执行重复任务的卓越助理”,价值判断和复杂沟通则由师生与各部门的互动完成。一个小而精的跨部门工作组,效率远超一个臃肿的专职团队。
减法的目的是“专”:
垂类深耕与弯道超车
做完减法之后,腾出来的资源和精力,要集中投入一件事:打造属于本校的垂类深度。
为什么要建垂类模型?通用大模型的战场,省属高校没有入场券。但教育垂类模型不同,它不拼算力,拼的是场景贴合度、数据独占性和业务理解深度,三者都是省属高校的天然优势。每一所省属高校都有自己的特色学科、独家教学数据和独特的办学定位,这些都是通用大模型永远无法复制的护城河。
以武汉科技大学为例。作为一所冶金、材料学科优势突出的省属高校,武科大无需与综合类大学在通用AI能力上比拼,而应将资源集中于最能体现自身特色的垂直场景。
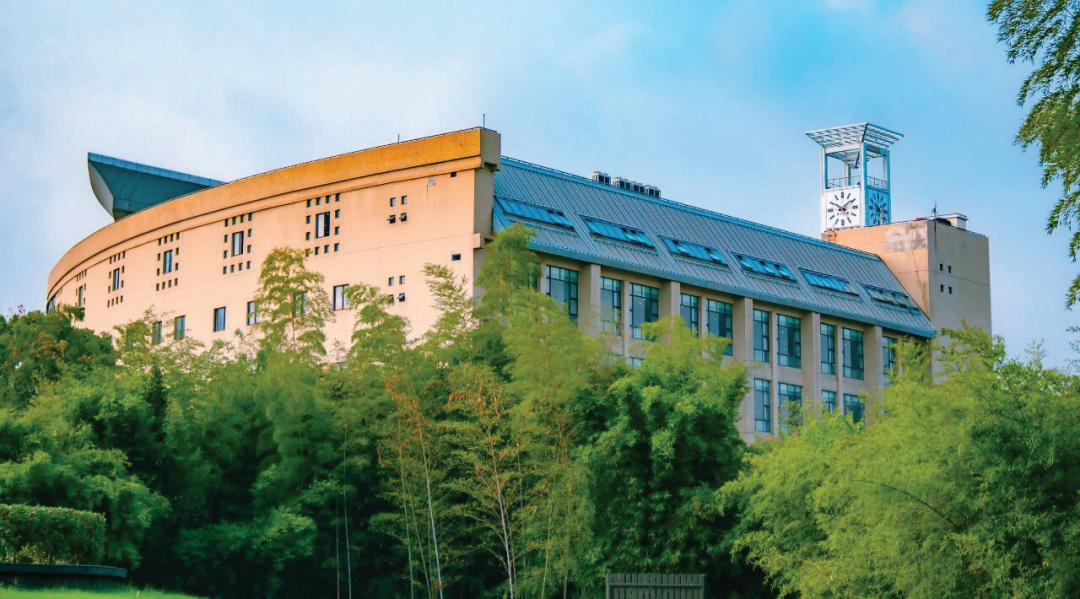
武汉科技大学
例如,可打造冶金和材料学科的垂类模型,整合本校专业教材、实验报告、历年学科文献,搭建面向冶金工艺、材料性能分析等方向的智能问答与实验仿真辅助工具,形成独属于本校的工科AI服务能力;可打造论文智能审查系统,不仅检测格式,更分类汇总本校学生的高频错误类型,为每位毕业生生成个性化自查清单;可打造“智慧选课”系统,基于历史选课数据预测热门课程竞争热度,为学生推送适配替代方案,联动学业预警实现个性化规划。一个深度打磨的垂类应用,价值远超十个浅层的通用功能。
这也是出于“弯道超车”的逻辑。弯道超车不是投机取巧,是在部属高校还在比拼通用能力的直道上时,提前切入对手尚未覆盖的细分赛道。在多数高校还停留在通用部署阶段时,垂类深耕的窗口期依然敞开。省属高校如果现在就在特色学科垂类模型上建立先发优势,随着数据积累和模型迭代,这种优势将越来越难以被后来者追平。资源上的劣势,可以在细分赛道上转化为时间上的优势。
保持耐心:
减法之后的持久战
减法的目的是集中力量,站稳之后要持续发力。
一要做深体验。商业大模型只有通用的教育知识,无法适配某一所高校具体的办学流程、专业体系和规章制度。这正是省属高校垂类平台不可替代的价值。针对本校特色专业定制专属交互功能,可以让校内AI工具比DeepSeek更懂本校的规范制度、学科课程,更懂本校的师资和优势,更懂本校师生的习惯。建立常态化反馈通道,每一次迭代都回应真实问题。这种精细化运营的能力,是商业模型永远无法提供的本土优势。
二要守护安全。教育部《教育数据分类分级指南》已为数据治理提供了制度框架。在微调垂类模型之前,必须完成校内敏感数据的脱敏处理,严格限制学籍、个人信息和未公开科研数据的外流。配套搭建算法审计、分级授权和伦理审查机制。
三要持续学习。垂类模型需要定期微调更新,团队能力也需要持续迭代。管理层提升数智化统筹与赛道规划能力,技术团队掌握模型微调、AI Agent搭建和垂类数据治理等实操技能,一线教师完成从“不会用”到“用于教学科研”的进阶。当前高校AI建设和能力的演进速度,将决定谁能把先发优势转化为长期壁垒。
结语
省属高校AI建设最大的风险,从来不是建得太慢,而是建得太散。
“做减法”的意义,在于清醒地知道自己的资源边界在哪里,清醒地知道通用大模型的赛道上没有省属高校的机会,清醒地知道垂类深耕赛道才是真正属于自己的战场。
对省属高校的信息化工作者而言,在规划年度AI建设方案之前,值得先列一份清单:我们不建什么。把有限的力量集中到最有价值的垂类场景上,看似在收缩,实际上是在最正确的方向上加速。资金、人力不及部属高校这一点,无需悲观。通用大模型拼算力,垂类大模型拼场景、拼数据、拼对一所学校的深入理解——这三样东西,每一所省属高校都有,而且独一无二。
参考文献:
[1]何雅妍,周保民.基于典型应用场景的“人工智能+高等教育”深度融合机理研究[J]. 中国高教研究,2026(3):21-29.
[2]姜思羽,胡科.世界一流高校对生成式人工智能的态度、策略及其启示[J]. 黑龙江高教研究,2025,43(12):45-54.
来源:《中国教育网络》2026年9月刊
作者:涂伟(武汉科技大学网络信息中心)
特别声明:本站注明稿件来源为其他媒体的文/图等稿件均为转载稿,本站转载出于非商业性的教育和科研之目的,并不意味着赞同其观点或证实其内容的真实性。如转载稿涉及版权等问题,请作者在两周内速来电或来函联系。
投稿、转载或合作,请联系:eduinfo#cernet.com (请将#替换为@)
版权所有:中国教育和科研计算机网网络中心 CERNIC,CERNET
京ICP备15006448号-16 京网文[2017]10376-1180号  京公网安备 11040202430174号
关于假冒中国教育网的声明 | 有任何问题与建议请联络:Webmaster@cernet.com